O NLP é uma das principais buzzwords do mercado atualmente, comumente associada/confundida com o conceito de chatbot em si, o NLP é Natural Language Processing ou o Processamento de Linguagem Natural.
A concepção desta tecnologia remonta à década de 1950 com Alan Turing, um dos países da computação moderna, e um dos primeiros chatbots criados com processamento de linguagem natural foi ELIZA, em 1966, um programa primitivo de computador que, simulando uma psicoterapeuta, era capaz de fornecer respostas surpreendentemente humanas a partir de compreensão de inputs de texto.
Agora, por que processamento de linguagem natural? O que exatamente isso significa?
Em curtos termos, existe uma distinção simples entre as estruturas de linguagem faladas por humanos (as naturais, como o Português, o Inglês, o Árabe, o Swahili...) e as compreendidas pelas máquinas (as formais, como binário, Assembly – de baixo nível –, Java, Python, JavaScript, Go, Ruby – de alto nível – e uma infinidade de muitas outras. Não entraremos nisso por aqui.
Você dizer que processará linguagem natural significa basicamente empoderar a máquina, que compreende nativamente linguagens formais, a interpretar linguagens naturais, ou seja, de ordem humana e com semântica abstrativa.
Por que isso virou um assunto tão comentado e requisitado agora? Se a tecnologia (assim como o conceito de Machine Learning) já possui mais de meio século de existência?
Dentre os fatores determinantes para o boom moderno do NLP, estão o advento das capacidades de processamento de informações em larga escala possibilitada por grandes cloud providers; a massificação de canais conversacionais como o Messenger e o WhatsApp, possibilitando que softwares conversacionais pudessem ganhar maior espaço como frentes de negócio; a "comoditização" e estruturação em larga escala desta tecnologia e, por fim, uma ampla evangelização de público, fator inclusive escalado pela própria Zenvia nos últimos anos.
Todos estes quatro pontos araram terreno fértil para que o processamento de linguagem natural se tornasse algo realmente sólido ultimamente.
Isto posto, é importante enxergar esta tecnologia como uma ferramenta que, dentro de uma visão mais holística, pode entregar bons resultados como componente de um produto. Saber dominá-la, no contexto de chatbots, é saber dominar complexidades que podem simplificar, em muito, as vidas dos usuários e dos implementadores.
Antes de prosseguirmos, um pequeno glossário de termos próprios do NLP para que todos fiquemos na mesma página:
Intent: As intenções são as ações que os usuários potencialmente desejem ativar nos chatbots que podem ser traduzidas em funcionalidades ou em direcionamentos, no caso de o chatbot conseguir mapear o caso, mas não tratar. Em termos mais práticos: se um usuário diz “eu gostaria de comprar uma passagem”, esta frase pode ser interpretada como a intent 'comprarPassagem' e direcionar o usuário para um fluxo de compra. As intents normalmente são treinadas com corpus de utterances.
Entities: As entidades são partículas de uma frase que modificam seu contexto geral ou que geram outputs para que o chatbot execute uma função específica. Por exemplo, na frase “Quero comprar uma passagem de São Paulo para Porto Alegre”, tanto “São Paulo” quanto “Porto Alegre” se configuram como entidades de local, e, pela ordenação delas na estrutura semântica da frase, devem representar, respectivamente, origem e destino, devolvendo portanto a intent 'comprarPassagem' da metrópole paulistana para a capital gaúcha. Num outro exemplo, ao ser perguntado por um usuário com “como estará a temperatura depois de amanhã em Birigui?”, um chatbot deverá interpretar “depois de amanhã” como data e Birigui como local na intent pesquisar clima, portanto devolvendo a temperatura dali a dois dias na referida cidade.
Utterances: Do português “enunciados”, são as frases proferidas pelos usuários, que podem ser analisadas pelo algoritmo de acordo com o corpus de treinamento, construído a partir de frases coletadas pelo desenvolvedor/designer/builder.
Corpus de treinamento: Banco de dados com strings de texto marcadas como intenções e com palavras rotuladas como entidade para serem submetidas a um processo de Machine learning para garantir ao chatbot o poder de interpretar e processar linguagem humana.
Treinamento: Ato de rodar o algoritmo para atualizar o corpus ou modelo de treinamento e afinar o processamento de linguagem natural para melhor compreender os inputs dos usuários.
Machine Learning: Tecnologia capaz de permitir a uma máquina realizar inferências probabilísticas a partir de um modelo de treinamento de onde seja possível extrair um padrão semântico, numérico, físico etc.
Treinamento é importante!
Treinamento é importante!
“Mas o robô não aprende sozinho?”. “Mal posso esperar para colocar um Machine learning aqui e nunca mais ter que me preocupar em desenhar um fluxo”. “Vou plugar isso aqui no Watson...”.
Atire a primeira pedra quem, nos últimos anos, não ouviu nenhuma destas frases de algum cliente, concorrente, usuário, aspirante a Chat Master ...
Tudo normal, considerando a empolgação como sintoma de um certo deslumbramento causado pelo marketing gerado em cima das possibilidades infindáveis de construção de produtos incríveis com esta interface em ascensão. Por outro lado, este ânimo todo nos trouxe a ideia errônea de que estes componentes, nutridos por aprendizagem de máquina, são autossuficientes na resolução de problemas complexos – e não são.
Para um motor de NLP à base de Machine learning supervisionado ou semi-supervisionado (como é o caso dos motores dos principais players deste mercado, a ver: Google Dialogflow, Microsoft LUIS, IBM Watson, Facebook Wit.ai, Rasa...), não há nada mais importante do que uma base de dados bem construída, posto que as inferências geradas por este tipo de inteligência artificial são construídas a partir de observação de padrões e taxas de confiança. Em outras palavras, quanto maior for o número de exemplos que o algoritmo tiver à disposição como base de treinamento, maior a possibilidade de ele dar um chute correto a respeito dos inputs dos usuários.
O motivo de levantar este tópico está justamente em oposição ao deslumbre da tecnologia que aprende sozinha. É simplesmente impossível criar um modelo de treinamento com meia dúzia de exemplos para cada intenção – principalmente num escopo mais aberto – e esperar performance minimamente próxima à da interpretação humana. Não existe, entretanto, um número mágico para um algoritmo começar a responder em alta performance: o contexto e a matéria do fato podem gerar oscilações de resultados. Mas uma coisa é certa: sem uma grande quantidade de dados e exemplos a serem consumidos, não é possível esperar uma grande acurácia.
Para se ter uma base de comparação, um grande projeto de call center automatizado de uma operadora brasileira, para atingir 86% de efetividade em seu NLP, chegou a cadastrar mais de 45.000 frases distribuídas em 56 intents, o que dá uma média de 804 exemplos de treinamento para cada intent. Esta base foi construída tanto a partir de hipóteses de uso quanto de estudos em cima de inputs reais dos consumidores da marca.
Este trabalho de curadoria e colheita de inputs é extremamente importante no longo prazo para garantir a afinação dos algoritmos, então convém sempre garantir que o chatbot construído na nossa plataforma possa armazenar cada input como uma variável que possa ser lida a posteriori, seja para garantir as taxas de assertividade, seja para ter insumos para retroalimentar treinamentos frequentes.
Entendendo APIs Json
Entendendo APIs Json
Nesta série de artigos, explanaremos em termos gerais como integrar o Zenvia Flow a cada um dos maiores cloud providers do mercado: Google DialogFlow, IBM Watson e Microsoft LUIS. Todos eles, por serem aplicações desenvolvidas para se integrarem a sistemas, possuem REST APIs abertas que podem receber chamadas GET em Json e devolver diversos objetos nesta notação para o usuário.
Este detalhe faz com que elas sejam absolutamente integráveis à plataforma Zenvia, bastando apenas entender como estruturar cada chamada e quais dados extrair. Todos os componentes mencionados acima (intents, entities, utterances) podem ser utilizados na construção de sua integração para deixa-la mais rica. Mas uma coisa deve ficar clara: para quem for mexer com NLP, o componente de Json API da Zenvia será o mais importante recurso a ser utilizado.
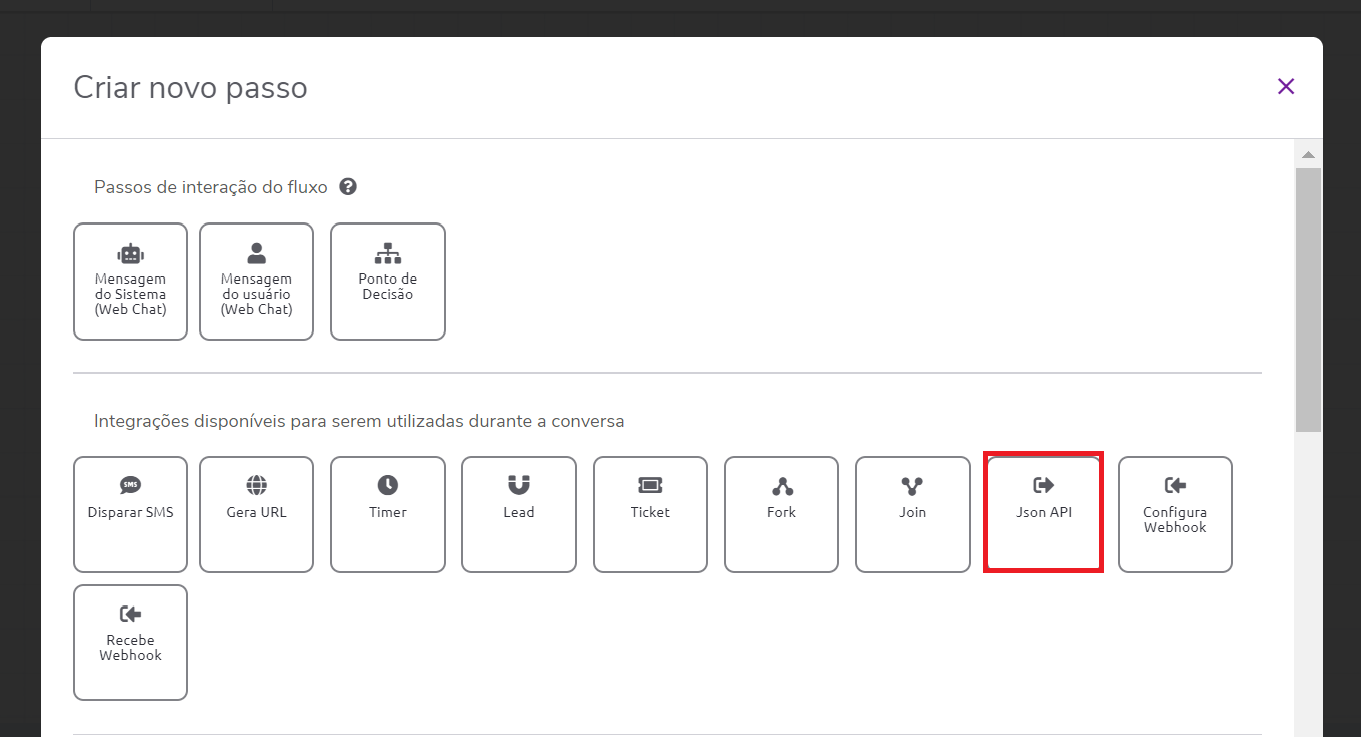
Para quem não se familiarizou ainda com este pedaço da ferramenta, aqui vai uma ligeira explicação sobre como utilizá-la:
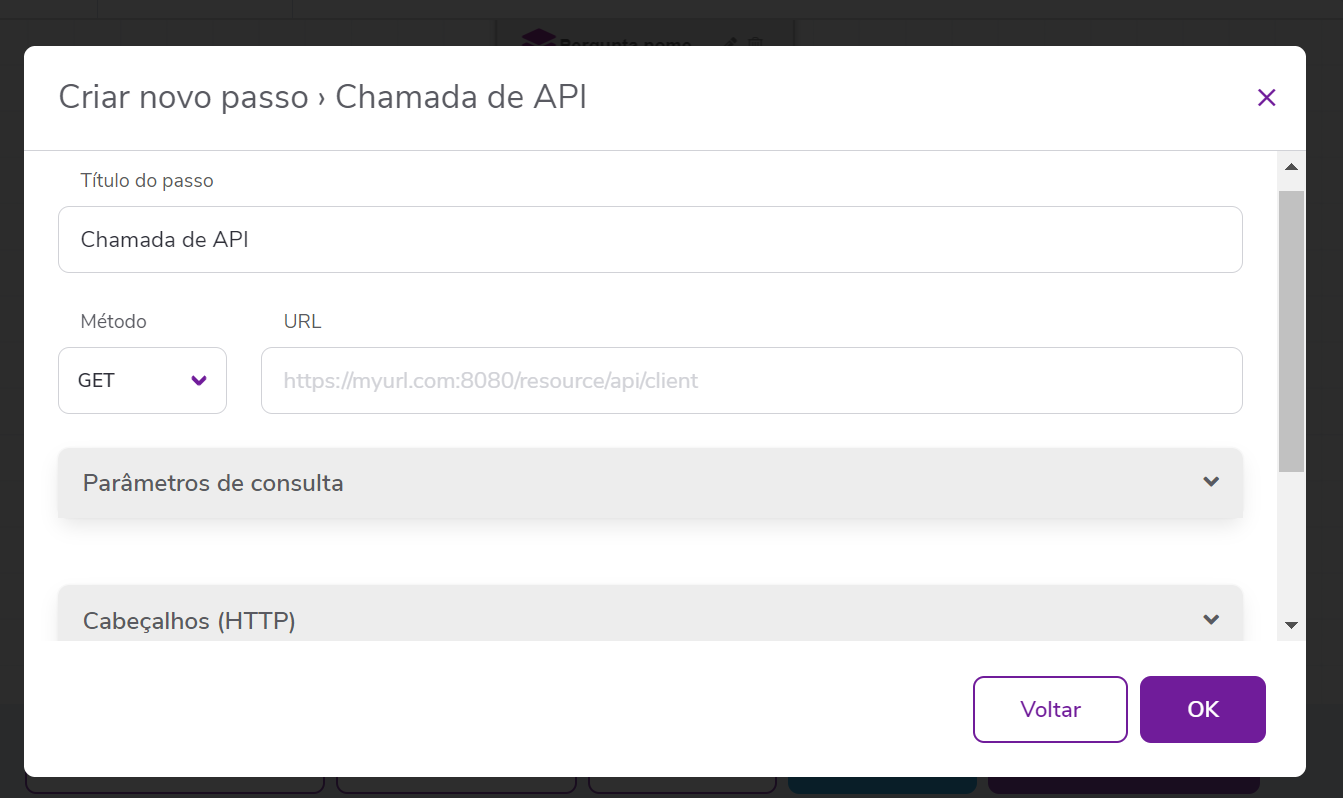
Método: Forma como a API será chamada. Neste caso, usaremos o método GET que, a partir de parâmetros de consulta informados pelo usuário, irá consultar a API e recuperar de lá
URL, o endpoint que será chamado para fazer a consulta ao NLP.
Parâmetros de consulta: Informações necessárias para que a API responda de acordo. Normalmente são preenchidos com a query do usuário, mas também podem ser agregados à URL. Desta forma, o preenchimento pode ser tanto assim:
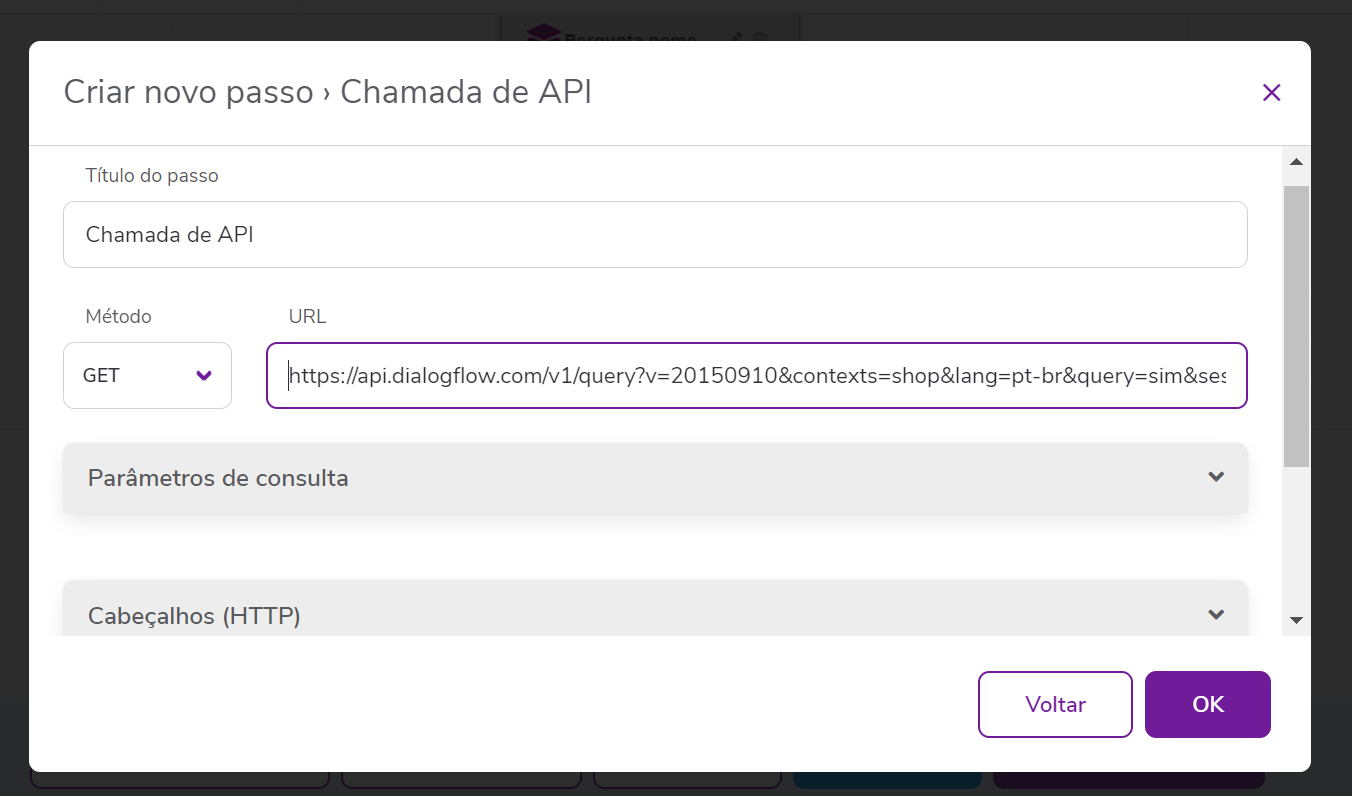
Quanto assim:
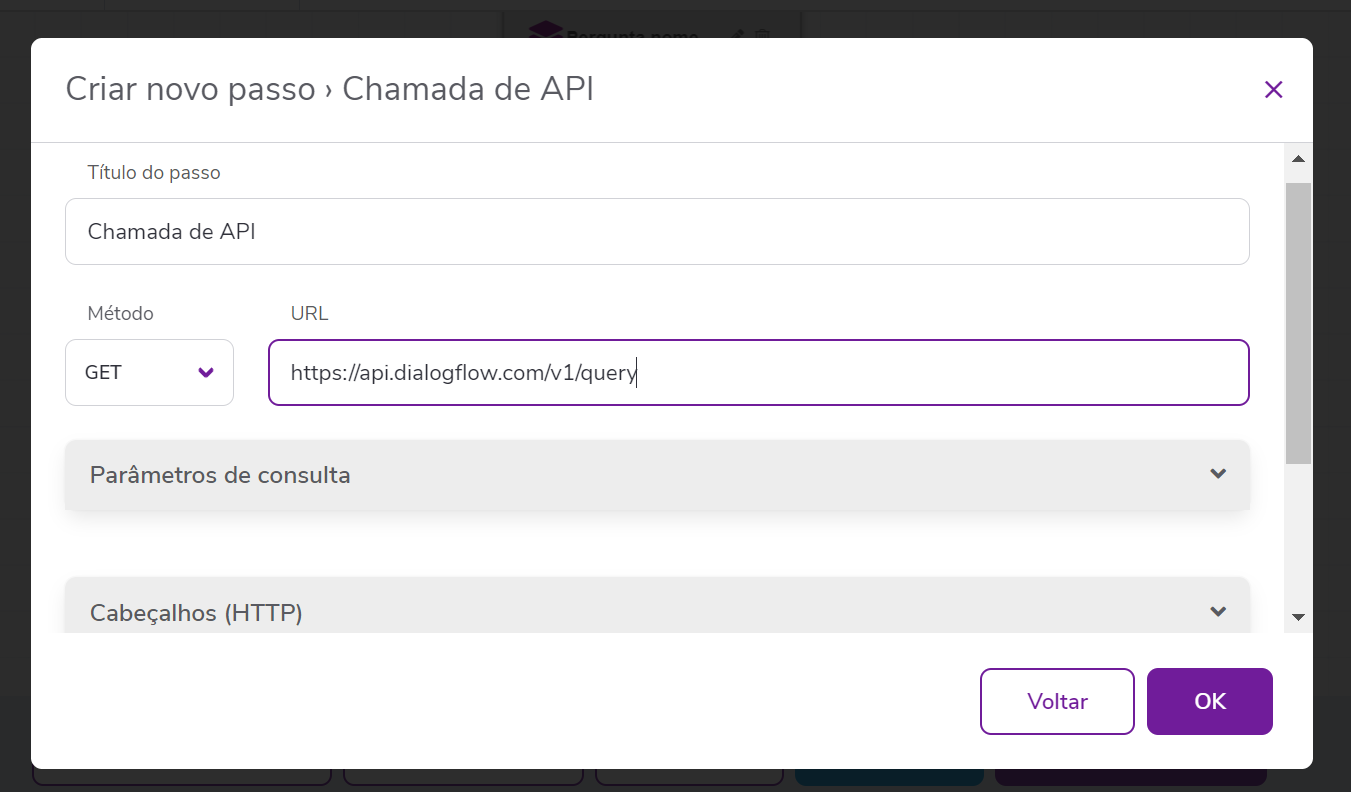
No primeiro caso, todos os parâmetros de consulta são chamados direto na URL, enquanto no segundo eles estão divididos nas caixas da própria plataforma. Fica a critério do usuário qual padrão escolher, pois ambos funcionam.
Configurações avançadas: Aqui, o Zenvia Bots define onde ficarão armazenadas as informações originadas da API de NLP. Para isso, basta criar um nome de parâmetro em “Nome” e definir qual o caminho que será percorrido pelo Json por expression language SPEL até a informação de
interesse.
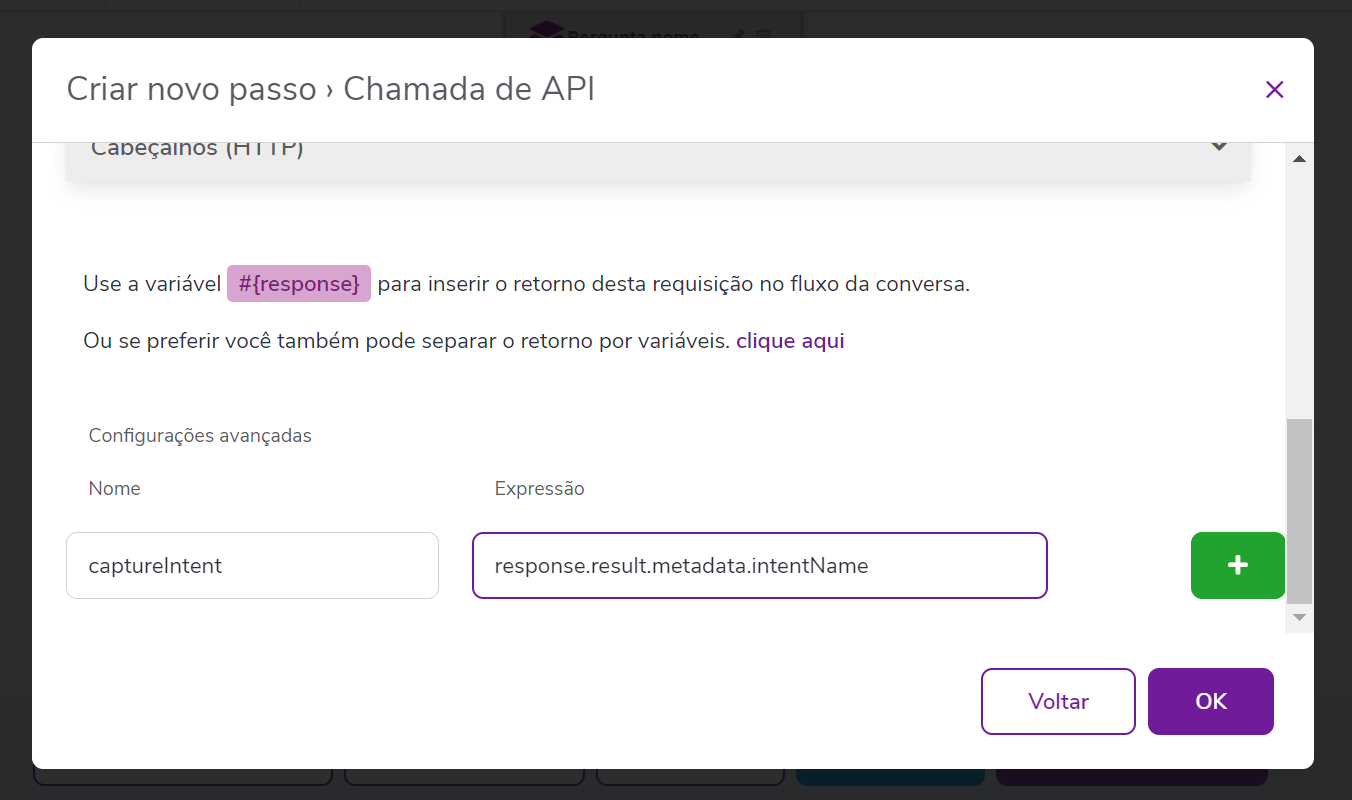
Esta certamente é a parte menos simples de compreender, então por isso veremos um exemplo prático. Na chamada GET para o link https://api.dialogflow.com/v1/query?v=20150910&contexts=shop&lang=pt-br&query=sim&sessionId=12345&timezone=America/New_York, a informação que nos interessa para gerar um atributo que permita ao bot tomar uma decisão é 'intentName”, em negrito abaixo:
{
"id": "24287cf1-7a77-4f72-9b72-9078fe68f6d5-d5ae01f3",
"lang": "pt-br",
"sessionId": "12345",
"timestamp": "2019-10-23T20:45:16.407Z",
"result": {
"source": "agent",
"resolvedQuery": "sim",
"action": "",
"actionIncomplete": false,
"score": 1.0,
"parameters": {},
"contexts": [
{
"name": "shop",
"lifespan": 4,
"parameters": {}
}
],
"metadata": {
"intentId": "2a55ae72-54c6-42a5-9b1a-1cfc7afd7c4e",
"intentName": "RespostaPositiva",
"webhookUsed": "false",
"webhookForSlotFillingUsed": "false",
"isFallbackIntent": "false"
},
"fulfillment": {
"speech": "",
"messages": [
{
"lang": "pt-br",
"type": 0,
"speech": ""
}
]
}
},
"status": {
"code": 200,
"errorType": "success"
}
}
Este parâmetro 'intentName' está dentro de um objeto 'metadata', que por sua vez está dentro de 'result', que está no mais alto nível da resposta (response) Json. Desta forma, a expression language que deverá ser montada para capturar este atributo é response.result.metadata.intentName, sob um nome qualquer que o usuário queira definir (por exemplo, 'captureIntent').
Este parâmetro ficará armazenado no contexto de sessão do chatbot, e poderá ser usado tanto para tomada de decisões quanto para geração de relatórios. Nos próximos artigos, veremos como melhor definir estratégias para realizar estas integrações com os diferentes fornecedores de NLP do mercado.